В Канаде искусственный интеллект создал неожиданную проблему для библиотек

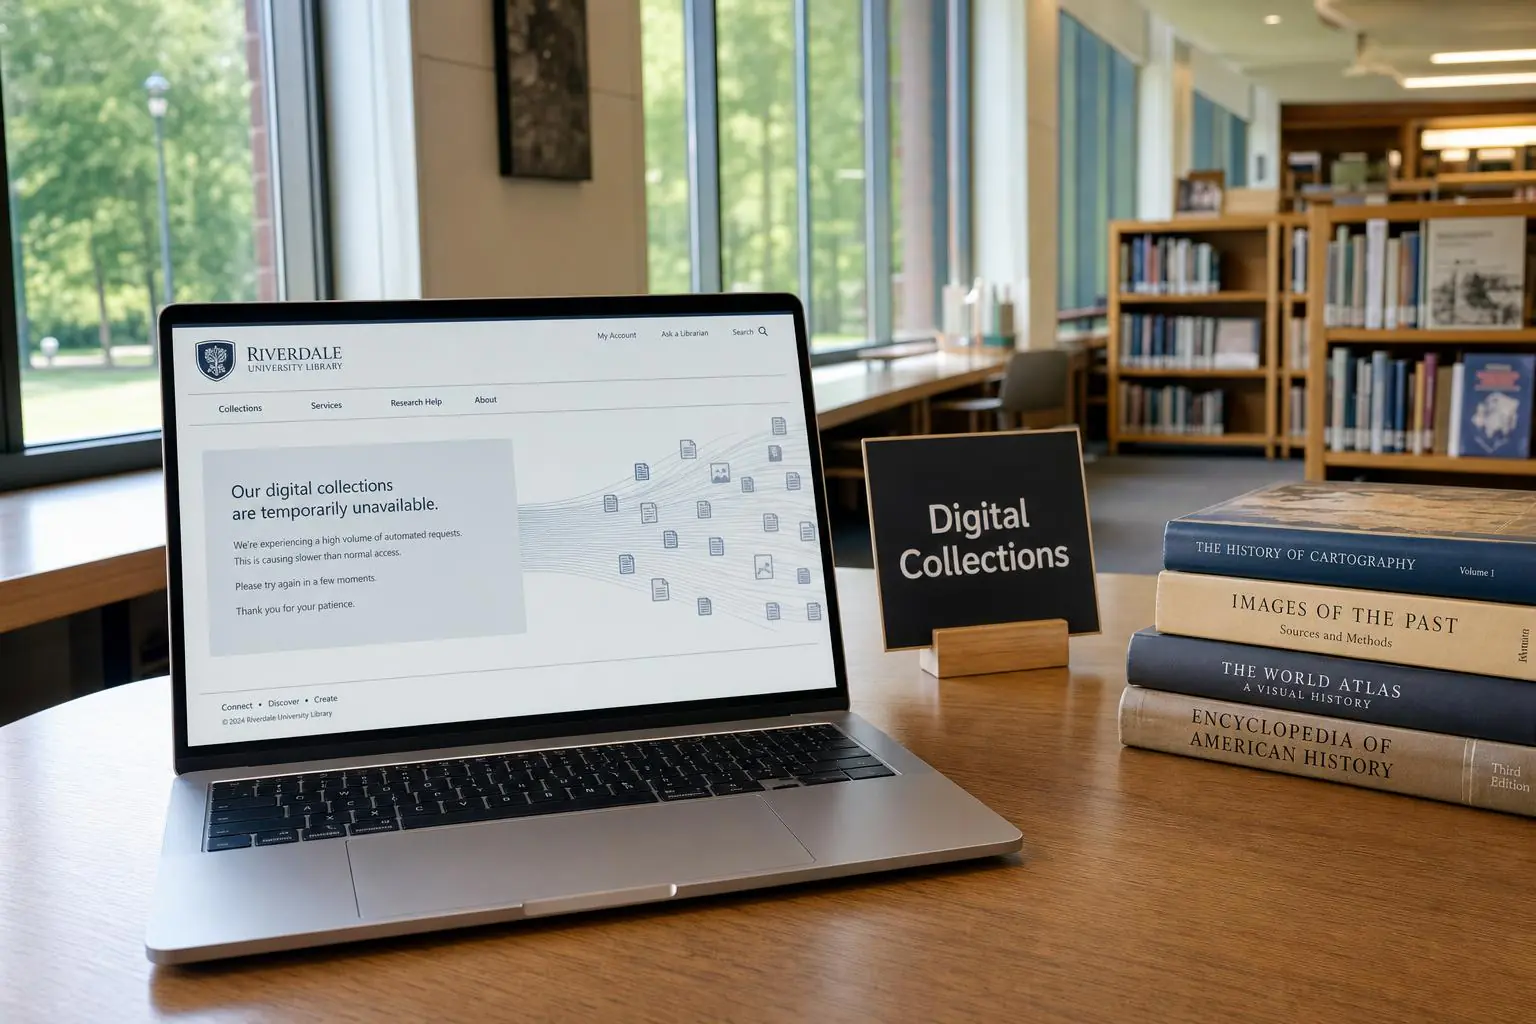
Фото создано искусственным интеллектом для иллюстрации
Университетские библиотеки по всему миру все чаще сталкиваются с волнами автоматического трафика: боты массово скачивают книги, статьи и архивные материалы, чтобы использовать их для обучения систем искусственного интеллекта. В результате онлайн-каталоги и цифровые коллекции заметно тормозят или на время становятся недоступны - и в первую очередь страдают студенты, исследователи и обычные читатели, которые приходят за открытыми ресурсами.
«Нас буквально бомбардируют запросами»,- описывает ситуацию Джилл Стрыковски, отвечающая за каталогизацию и правительственные документы в Университете штата Сан-Хосе. По ее словам, цель проста: выкачать из интернета как можно больше контента. За такими загрузками стоят не только ИИ-компании, но и сторонние структуры, которые собирают данные «оптом» и затем продают или передают их разработчикам больших языковых моделей - вроде Claude, Gemini и ChatGPT.
Библиотеки, музеи и другие учреждения, которые хранят культурное наследие, оказываются особенно удобной мишенью. У них накоплены проверенные, качественные материалы - и часто они открыты для всех, без платных подписок и обязательной регистрации. Для организаций, которые годами вкладывались в оцифровку и открытый доступ, это оборачивается лишней нагрузкой и постоянной головной болью.
Первые массовые сообщения о подобных инцидентах, как отмечают исследователи, начали появляться в конце 2024 года - в Северной Америке, Европе и Океании. И, судя по словам специалистов, хуже становится буквально с каждым месяцем. Директор по коллекциям и цифровой инфраструктуре библиотек Университета Виктории Дин Симэн рассказывает: иногда поток запросов бывает таким, что сайт просто падает и некоторое время не поднимается. Это уже не техническая неприятность, а прямая угроза общественному доступу.
Канадский исследователь Питер Льюис, Canada Research Chair по надежному ИИ в Ontario Tech University, сравнивает происходящее с попыткой обычных пользователей «соперничать» с бесконечным конвейером запросов бот-ферм. По его оценке, крупные частные компании ведут себя по отношению к общественно значимым институтам крайне экстрактивно: подразумевают, что материалы всегда будут доступными и бесплатными, а затем на их основе создают коммерческие продукты и продают их обратно тем же пользователям.
Исполнительный директор Project Gutenberg Эрик Хеллман раньше называл такие краулеры плохо запрограммированными «монстрами», которые разрушают открытый интернет. Теперь, говорит он, все стало только хуже. Хеллман подчеркивает: существуют «хорошие» боты - например, у поисковиков или у Internet Archive, - которые ориентируются на правила robots.txt, то есть на добровольные инструкции сайта о том, что можно индексировать и с какой интенсивностью. Однако скрейпинговые ИИ-боты нередко игнорируют эти ограничения и перегружают ресурсы - в отдельных случаях запрашивая тысячи документов в секунду и скачивая их сразу во всех доступных форматах.
Новости интереснее, когда есть с кем их обсудитьПознакомьтесь с русскоязычными людьми из Ванкувера и других городов Канады. Возможно, тот самый человек уже совсем рядом.Посмотреть, кто сейчас на сайте →
Как передает CBC News, один из самых наглядных эпизодов произошел в Университете Северной Каролины в Чапел-Хилле. В прошлом году вуз сообщил о более чем 11 тысяч поисковых запросов по финской музыке за один день - причем они пришли с тысяч разных интернет-адресов. Из-за этого библиотечный каталог периодически становился недоступен для студентов, преподавателей и сотрудников.
По словам Хеллмана, прежний привычный метод - блокировать «плохие» IP - сегодня почти не работает: одна компания или бот-ферма может разбрасывать трафик по тысячам адресов. При этом Project Gutenberg, подчеркивает он, в целом не возражает против использования своих материалов для обучения ИИ и даже предлагает возможность скачать всю коллекцию «в один клик». Проблема в том, что «боты слишком глупы, чтобы воспользоваться этим» - вместо этого они долбят сайт тысячами однотипных запросов. Почти все тексты Project Gutenberg находятся в общественном достоянии, и именно такие легальные массивы, считает Хеллман, и следует использовать, но делать это нужно уважительно, не выводя инфраструктуру из строя.
Чтобы отсеивать автоматический трафик, некоторые библиотеки начали ставить CAPTCHA и другие проверки. При этом, предупреждает Майкл Вайнберг, соруководитель GLAM-E - инициативы по политике открытого доступа для культурных институций на базе NYU Law School и Университета Уорика, - такие меры часто бьют и по «хорошим» ботам, например по тем, что помогают индексировать коллекции и делать их более доступными. Часть учреждений обсуждает вариант с логином и паролем, однако это вызывает острые споры: библиотекари и исследователи не хотят превращать открытые ресурсы в закрытые только из-за того, что кто-то пришел «собирать все подряд».
При этом специалисты признают: по мере развития технологий автоматические сборщики данных будут все лучше обходить ограничения. На фоне критики и судебных исков по авторскому праву большие ИИ-компании в целом продолжают утверждать, что сбор общедоступных данных для обучения моделей допустим как fair use и якобы отвечает общественным интересам. При этом Anthropic, Google и Microsoft, как сообщается, на прошлой неделе поддержали идею единого стандартизированного сигнала отказа от скрейпинга в robots.txt, который мог бы блокировать их веб-краулеры. Однако проблема в том, что соблюдение этих правил остается добровольным - и не решает вопрос с ботами третьих сторон, подрядчиков и небольших стартапов.
Вайнберг напоминает: оцифровка и публикация архивов - одно из самых заметных достижений последних десятилетий. То, ради чего еще 20 лет назад нужно было ехать в другую страну или получать специальный допуск, сегодня доступно в пару кликов. При этом, если атаки ботов продолжатся, у учреждений появится опасный стимул «лучше не выкладывать» часть материалов в открытый доступ. И это, подчеркивают эксперты, ударит по всем - хотя общественная ценность цифровых библиотек и музейных коллекций остается огромной.